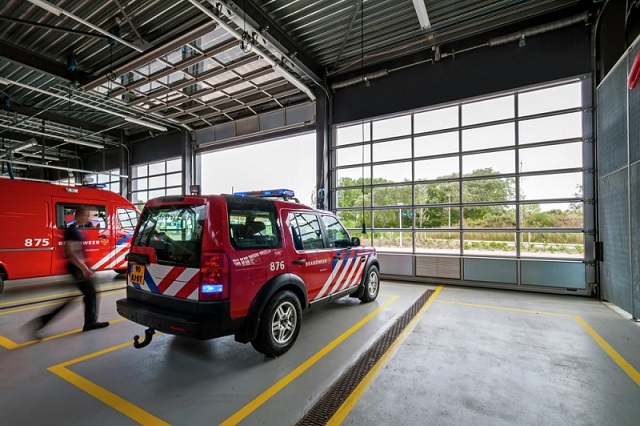
In unserer modernen Infrastruktur sind automatisch betriebene Türen und Tore nicht mehr wegzudenken, denn diese ermöglichen eine effiziente Logistik, ergonomisches Arbeiten und schnelle Reaktionszeiten von Rettungsdiensten. Automatische Türen und Tore können jedoch auch zur Gefahr werden. Damit die Sicherheit gewährleistet bleibt, sind diese jährlich zu warten und eine Schließkraftmessung durchzuführen.
Wartung von Industrietoren und Türen im Verkehrswesen: Schließkraftmessung bei kraftbetätigten Toren
Damit Unfälle am Arbeitsplatz sich so selten wie möglich ereignen und, sollte es zu einem Unfall kommen, wenigstens allzu schwere Verletzungen vermieden werden, hat der Gesetzgeber einige Regelungen bezüglich des betrieblichen Alltags aufgestellt. Dem Gesetzgeber ist daran gelegen, dass Gefahrenquellen vermieden werden und durch regelmäßige Wartungsarbeiten sichergestellt wird, dass betriebliches Equipment funktionstüchtig und gefahrlos in Betrieb genommen werden kann.
Das klingt freilich logisch, nur leider zeigt die Praxis, dass es des Öfteren bei für den Betrieb als selbstverständlich betrachteten Bestandteilen zu Vernachlässigungen hinsichtlich der Wartungspflicht kommen kann. Besonders stiefmütterlich werden beispielsweise Industrietore und Torsysteme behandelt. Die Industrietore vieler Betriebe überschreiten die zugelassenen Werte um ein Vielfaches. Darauf hat der Gesetzgeber reagiert und 2013 in der Arbeitsstättenregel ASR A1.7 neue und strengere Regelungen, was die Schließkräfte von Industrietoren angeht, festgesetzt.
Big Data Analytics ist der Trend für das Jahr 2015. Im Unterschied zum traditionellen Business Intelligence, bezieht Big Data Analytics alle unternehmensinternen Daten und externe Datenquellen ein. Externe Datenquellen können beispielsweise Social Media Plattformen, Börsen und Handelsplattformen sowie Behörden (Open Data) sein. Auch der aktuelle Trend zur Industrie 4.0 (Smart Factory) bedient sich dieser Analyseverfahren.
Mit diesen Trends erlebt auch die Programmiersprache für statistische Datenanalyse R einen enormen Aufschwung. Mit R lassen sich einfache statistische Datenanalysen durchführen oder automatisierte Analyseverfahren entwickeln, aber auch Predictive Analytics wird häufig mit R als Analysekern realisiert. R ist zudem grundsätzlich kostenlos und Open Source. Übrigens zählen R-Programmierer zu den Entwicklern mit den höchsten Stundensätzen bzw. Gehältern und IT-Experten.
Nachfolgend zwei ausgewählte Buchempfehlungen für den Einstieg in die Programmierung und Analyse mit R und zur Erweiterung von bestehenden R-Kenntnissen.
Das Buch Programmieren mit R von Uwe Liges mit einer schrittweisen Einführung in R von Anfang an. Mit der Nutzung von R als Taschenrechner wird leicht verständlich in R eingewiesen. Wer schon weiter ist oder die 225 Seiten des Buches durchgearbeitet hat, versteht es bereits, objektorientierte Programme in R zu entwickeln, statistische Modelle zu entwickeln, lineare Optimierungen durchzuführen, Effizienzanalysen (z. B. Laufzeitanalysen) zu betreiben und sogar eigene Grafikfunktionen zu definieren. Das Buch umfasst die komplette Mächtigkeit in Bezug auf die Mathematik. Der Autor schafft es dabei, anfangs sehr didaktisch vorzugehen, ab ca. dem ersten Drittel jedoch die Themen klar voneinander zu trennen, so dass das Buch auch als Nachschlagewerk taugt. Eine ganz klare Empfehlung für Einsteiger und auch Fortgeschrittene!
Das Buch Datendesign mit R vom Autor Thomas Rahlf geht die Sache ganz anders an, als das oben genannte allgemeine Einführungs- und Nachschlagewerk für R. Der Autor stellt auf den ersten Seiten die Gestaltungsmöglichkeiten von R für Grafiken und Diagramme vor, wobei die Gestaltungsvorschläge prinzipiell unabhängig von dieser Programmiersprache sind und allgemeine Gestaltungstipps für Analyse-Reporting sind. Das Buch beinhaltet auf wenigen Seiten zwar auch noch eine kleine Einführung in R, diese ist jedoch nur ein kleines Beiwerk. Der Kern des Buches, und der tatsächliche Kaufgrund, sind die 100 Visualisierungsbeispiele, die tatsächlich visuell überzeugen, verständlich aufbereitet und dabei auch noch schön anzusehen sind. Dem Leser werden Möglichkeiten der Datenvisualisierung aufgezeigt, stets mit einem Anwendungsfall und echten (downloadbaren) Daten im Hintergrund. Dies macht nicht nur Statistik verständlicher, sondern der Leser erhält einen Eindruck, welche Diagramme in welchem Kontext die ideale Wahl sind, beispielsweise Balkendiagramme, Säulendiagramme, Kuchendiagramme, Histogramme, Verteilungsdiagramme, Lorenzkurven, Liniendiagramme, Zeitreihen, Radialpolygone oder Heatmaps.
Wer die Visualisierungen aus dem Buch nachbauen möchte, muss nicht unbedingt den Quellcode aus dem Buch abtippen, sondern kann diesen auch aus dem (als Download-Code) beigelegten eBook kopieren.
Zu einem guten Personalmanagement zählt nicht nur das Recruiting, also die Neuanstellung von Mitarbeitern, sondern – und dies wird tendenziell oft vergessen – auch die Personalentwicklung. Mitarbeiterqualifizierung sichert zukünftige Wettbewerbsfähigkeit, allen Risiken zum Trotz. Woran aber die wenigsten Unternehmen denken, ist Nachhaltigkeit von Wissen und Erkenntnisse, die Mitarbeiter im Namen des Unternehmens generiert haben, Stichwort Wissensmanagement. Erst mit ausgereiftem Wissensmanagement, können Mitarbeiter den höchsten Wirkungsgrad für das Unternehmen erreichen.
Wissensmanagement ist wichtig für den Erfolg jedes Unternehmens
Wenn man von Wissensmanagement spricht, spricht man vom Erwerb, der weiteren Entwicklung, dem Transport, der Speicherung und vor allem der Nutzung von Wissen. Vor allem in Unternehmen ist Wissensmanagement ein maßgeblicher Faktor, der den Erfolg oder Misserfolg maßgeblich beeinflusst. Um nachhaltig im Wettbewerb zu bestehen, müssen alle Ressourcen gezielt und optimal eingesetzt werden. Die wichtigste Ressource in jedem Unternehmen sind die Mitarbeiter. Diese sind der Motor für Erfolg und deren Wissen sollte dementsprechend genutzt und vor allem gefördert werden. Und genau hier liegt das Problem vieler Unternehmen, denn das Wissensmanagement wird teilweise nur unzureichend verfolgt. Ein Grund dafür ist Konkurrenzdenken unter den Mitarbeitern, insbesondere wenn Beförderungen in Aussicht stehen. Damit stellen Mitarbeiter ihre eigenen Ziele über jene des Unternehmens, es ist jedoch die gemeinsame Nutzung des Wissens aller Mitarbeiter notwendig, um nachhaltigen Unternehmenserfolg zu erreichen. Aus diesem Grund ist es unbedingt notwendig, das Wissen jedes Mitarbeiters produktiv zu verarbeiten und zu behalten.
Die Dissertation ist eine anspruchsvolle wissenschaftliche Arbeit, bei der Fehler idealerweise im Vorfeld zu vermeiden sind. Insbesondere bei der Erkenntnisgewinnung durch die statistische Auswertung von Daten können sich leicht Fehler einschleichen, vor allem dann, wenn der Doktorand im Umgang mit Statistik unerfahren ist.
Big Data ist eines der Buzzwords dieser Jahre und steht für das Potenzial der heranwachsenden Datenmengen für Wirtschaft und Wissenschaft. Das Potenzial ergibt sich aus dem Erfassen und Sammeln dieser Datenmengen aus den unterschiedlichsten Quellen. Die Nutzung des Potenzials erfolgt jedoch erst mit der Datenanalyse, daher wird oftmals zwar von Big Data geredet, jedoch Big Data Analytics gemeint.
Das in der Praxis am häufigsten vorkommende Datenbankmodell ist die relationale Datenbank, die Daten in untereinander verknüpfte Tabellenstrukturen speichert. Relationale Datenbanken sind zwar nicht direkt auf eine bestimmte Größe beschränkt, so begrenzt ausschließlich das Betriebssystem die Größe einer MySQL-Datenbank, dennoch tauchen bei großen Abfragen mit SQL-Queries oftmals schwer nachvollziehbare Fehler auf. Eine fehlgeschlagene SQL-Query lässt sich nur schwer debuggen, wenn sie nach Stunden abbricht.
Abhilfe verspricht Apache Hadoop mit einem verteilten Dateisystem (HDFS) und dem NoSQL-Ansatz und MapReduce-Algorithmus, der auch die Analyse von unstrukturierten Daten ermöglicht. Durch HDFS werden mit Commodity Hardware Datensammlungen und Analysen im Petabyte-Bereich möglich. Für die Auswertung der Datenmengen werden dadurch auch keine backup-kritischen Großrechner mehr benötigt, denn MapReduce-Jobs können auf verschiedener, räumlich getrennter Hardware zeitlich parallel erfolgen, erst die Ergebnisse werden auf einem dafür vorbestimmten Rechner (Server) zusammengetragen und weiterverarbeitet. Dabei werden Daten über die verteilte Hardware redundant gehalten, was als Data Warehouse (unter bestimmten Voraussetzungen) Ausfallsicherheit bedeutet.
Hadoop ist ein freies Open Source Framework, dessen Entwicklung von der Apache Software Foundation vorangetrieben wurde. Es wird auch von den Unternehmen eingesetzt, die heute als Pioniere von Big Data gelten, beispielsweise Facebook, Yahoo!, Twitter, Amazon und Google. Vor allem Google, Facebook und Yahoo! steuerten große Teile zu Hadoop bei.
Das Buch Hadoop – Zuverlässige, verteilte und skalierbare Big-Data-Anwendungen vom Autor Ramon Wartala bietet einen breiten und tiefen Einblick in Hadoop und dessen modulare Nebensysteme:
Datenfluss-Sprachen:
Hive
Pig
CludBase
Spaltenorientierte Datenbanken
HBase
Hypertable
Daten-Serialisierung
Avro
Thrift
Google Protocol Buffer
Sqoop
Workflow-Systeme
Azkaban
Oozie
Cascading
Hue
ZooKeeper
Mahout
Whirr
Das Buch führt ausführlich durch die Installation von Hadoop auf einem Linux-System, leitet die ersten Schritte im Umgang mit dem verteilten Dateisystem von Hadoop (HDFS) sowie zur Implementierung von MapReduce-Algorithmen an. Auch in die empfohlene Entwicklungsumgebung Eclipse (mit Plugin) wird hinreichend eingewiesen. Zum Ende gibt der Autor noch Tipps rund um das Management und die Überwachung der MapReduce-Jobs und des Hadoop-Ökosystems. Ferner werden vier Beispiele des Hadoop-Einsatzes in der Praxis vorgestellt. Wer einen Einstieg in die Praxis von Hadoop finden möchte, kann sich Hadoop als Standalone-Anwendung installieren und die Datenverteilung simulieren, oder sich Linux-Server bei Providern anmieten.
Hadoop besteht im Wesentlichen aus Java Programmcode (von Oracle, vormals Sun Microsystems), daher ist zumindest ein Grundwissen in Java notwendig, um tiefer in Hadoop eintauchen zu können und auch um die Quellcode-Beispiele im Buch verstehen zu können. Außerdem sind Linux-Kenntnisse (insbesondere Ubuntu/Debian) vorteilhaft. Wer kein Freund der Programmiersprache Java ist, kann durch das Hadoop Streaming auch MapReduce-Funktionen in C, Ruby, PHP oder Python realisieren; Hierfür bietet Hadoop eine Standardein/ausgabe-Schnittstelle an.
Die Community rund um Hadoop ist nahezu vollständig englischsprachig, für einen tieferen Einblick in Hadoop ist daher englischsprachige Literatur zu empfehlen, beispielsweise das Buch Hadoop: The Definitive Guide. Für einen ersten Einstieg in das Hadoop-System ist das obige deutschsprachige Buch jedoch absolut empfehlenswert.
Erfolgreiche Unternehmen versuchen Probleme zu identifizieren und zu lösen, solange sie noch klein sind und beschäftigen sich demzufolge nicht nur mit Symptomen und Kennzahlen, sondern auch mit ihnen zugrunde liegenden Ursache-Wirkungsketten.
Die Beschreibung von Prozessen und deren Darstellung in Prozessmodellen erfolgt bei Unternehmen häufig aufgrund von Kundenanforderungen oder externen Regelwerken, um die Schlüssigkeit der Unternehmensorganisation und Reproduzierbarkeit von Abläufen nach außen hin glaubhaft darzustellen.
Wesentlicher Treiber ist dabei der Nachweis der Qualitätsfähigkeit innerhalb einer Kunden-Lieferantenbeziehung oder der Nachweis der Erfüllung obligatorischer organisatorischer Sorgfaltspflichten.
Intern ist ein Führen mit Kennzahlen oder das Gestalten von Veränderungen im Unternehmen nur sehr eingeschränkt möglich, wenn es für wesentliche Geschäftsprozesse mehr informelle Regelungen als nachprüfbar dokumentierte Standards gibt.
Zur Planung, Beschreibung und Analyse von Prozessen haben sich in der Praxis eine Reihe von Vorgehensmöglichkeiten entwickelt, die je nach Zielstellung ausgewählte kritische Teilprozesse betrachten oder zusammenhängende Prozessketten, die z. B. Grundlage für eine Prozess-Simulation oder Prozesskostenrechnung sein können.
Notwendige Projekterfahrung im Geschäftsprozessmanagement oder die Komplexität verfügbarer IT Lösungen setzen in der Praxis den meisten Unternehmen jedoch Grenzen.
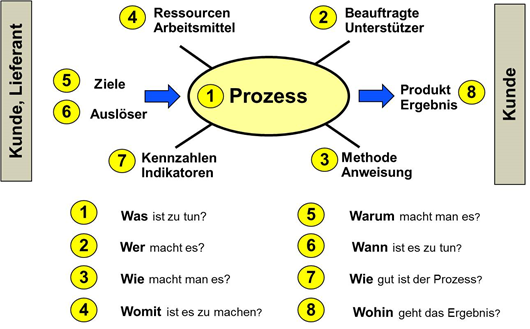
Für die einfache Darstellung und Analyse von Prozessen hat sich insbesondere im Bereich Automotive überwiegend das Turtle-Model (oder auch 8W-Modell) etabliert. Der Name Turtle rührt von der oft skizzierten Form einer Schildkröte her, wo Maul und Schwanz jeweils (Prozess-) Input und Output sowie die Gliedmaßen bestimmte Einflussfaktoren symbolisieren.
Die in klassischen Organigrammen und Prozessbeschreibungen zu findende Frage nach dem wer macht was wird beim Turtle-Model um das warum, wann, womit, wie, wohin und wie gut für jeden einzelnen Prozess-Schritt erweitert. Die Notwendigkeit einzelner Prozess-Schritte kann damit genau so kritisch betrachtet werden wie Unsicherheiten oder Unklarheiten bei der Regelung erfolgskritischer Details.
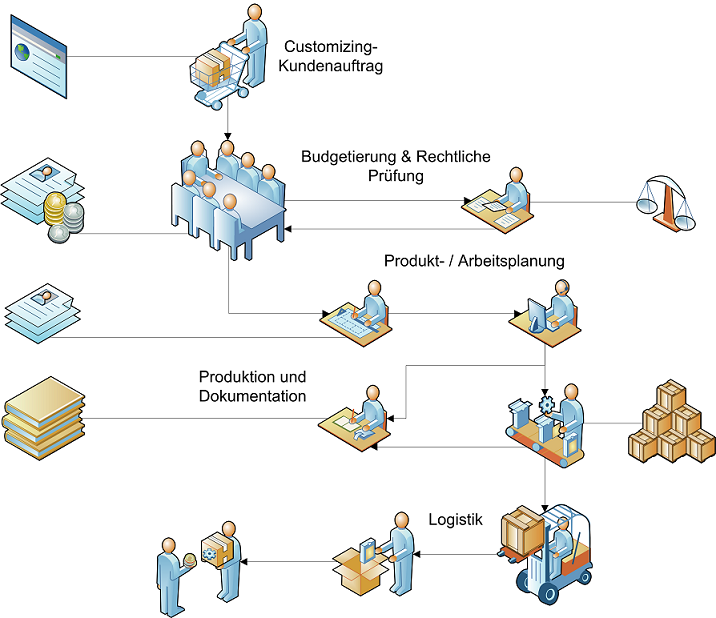
Das Zukunftsprojekt Industrie 4.0 wird unsere Industrie verändern. Produktions- und Lieferzeiten werden durch intelligente Steuerung verkürzt und hinsichtlich des Ressourceneinsatzes optimiert werden. Die virtuelle Realität wird Produkte von noch besserer Qualität schaffen, bei kostengünstigerer Produktentwicklung, die näher an die Fertigungsprozesse rücken wird. Durch das Internet der Dinge wird die Produktion und Logistik zuverlässiger sowie für Kunden transparenter werden. Insgesamt wird die Industrie 4.0 anders als die vorangegangenen Industrierevolutionen nicht nur insgesamt die Produktivität, sondern vor allem die Flexibilität erhöhen, bis hin zur kundenindividuellen Massenproduktion.
Die Fabrik 4.0 soll…
sich selbst digital abbilden und simulieren können und gleichzeitig möglichst mit der Realität verschmelzen,
Produktionssysteme, Produkte und Dienste mit Informationen ausstatten und miteinander kommunizieren lassen,
durch Datenanalysen in ihrer Situation aufgenommen, überwacht und im Generellen optimiert werden,
sich darauf aufbauend durch künstliche Intelligenz selbst steuern und im Speziellen auch selbst optimieren können.
Das Workflowmanagement (zu Deutsch etwa: Verwaltung von Arbeitsabläufen) steht dem (Geschäfts-)Prozessmanagement sehr nahe. Ziel des Workflowmanagements ist die Koordination von Prozessen über Workflowmanagementsysteme, indem sie die Ausführungsreihenfolge der Prozesse oder der Aktivitäten von Prozessen überwachen, Daten für die Ausführung von Aktivitäten bereitstellen, anstehende Aktivitäten menschlichen oder technischen Bearbeitern zur Ausführung zuordnen und Anwendungssysteme für die Bearbeitung zur Verfügung stellen.
Während die Steigerung der Produktivität im Produktionsbereich durch Prozessmanagement bereits früh erschlossen wurde, blieben Produktivitätssteigerungen im Bürobereich verhältnismäßig lange aus. In den 1980er Jahren begann sich mit der Office Automation und dem Ziel der computergesteuerten Durchführung wiederkehrender Vorgänge auch im Bereich der Büroarbeit Prozessmanagement durchzusetzen. Workflowmanagement ist jedoch nicht nur eine Büroangelegenheit, sondern dringt auch bis tief in die Produktionsplanung und -steuerung vor. Beispielsweise sind Stücklisten, Arbeitspläne, Produktionspläne usw. Arbeitsmittel und Kommunikationsmittel zwischen der Logistik- bzw. Produktionsplanung/-steuerung, die überwiegend als Bürotätigkeit geschieht, und der ausführenden Produktion. Auch die Erfassung der Arbeitszeiten und -tätigkeiten findet zwischen der Personalwirtschaft/Buchhaltung und der Produktion statt. Wann welche Arbeitsmitteln an welchem Ort bzw. bei welcher Person sein müssen und wer wann und wo welche Arbeitsschritte auszuführen hat, entscheiden Workflowmanagementsysteme.
Wirtschaftsingenieurwesen und Wirtschaftsinformatik sind interdisziplinäre Studiengänge und Fachbereiche zwischen Wirtschaft und Technik.
Wirtschaftsinformatiker und Wirtschaftsingenieure zeichnen sich durch exzellentes kaufmännisches Wissen aus, mit einem breiten und stellenweise sehr tiefen Einblick in technische Themengebiete, wie dem Maschinenbau, Bauingenieurwesen, der Chemie, Elektrotechnik oder Informatik.
Das Verständnis technischer Zusammenhänge und das betriebswirtschaftliche Wissen in Unternehmensführung, Personalwesen, Marketing, Controlling und Rechnungswesen schafft eine Qualifikationsbasis, die oftmals einen entscheidenden Karrierevorsprung ermöglicht. Wirtschaftsingenieure und Wirtschaftsinformatiker schaffen es deshalb im Durchschnitt schneller als alle anderen, sich in hohe Führungsetagen vor zu arbeiten oder eigene erfolgreiche Unternehmen zu gründen.
Mit der WIWI-Fachgruppe für Wirtschaftsingenieure und Wirtschaftsinformatiker können sich Absolventen und Studenten dieser oder ähnlicher Fachrichtungen (z. B. Wirtschaftsphysik oder Wirtschaftschemie) in ein fachbezogenes Netzwerk begeben und Kontakte knüpfen sowie Diskussionen führen, die bei der späteren Karriere hilfreich sein können.
Es reicht, Mitglied auf einer der beiden Plattformen zu werden, da Infos zu Veranstaltungen auf beiden Plattformen gleichermaßen bekannt gegeben werden.